Начните с вопросов, на которые нужен ответ
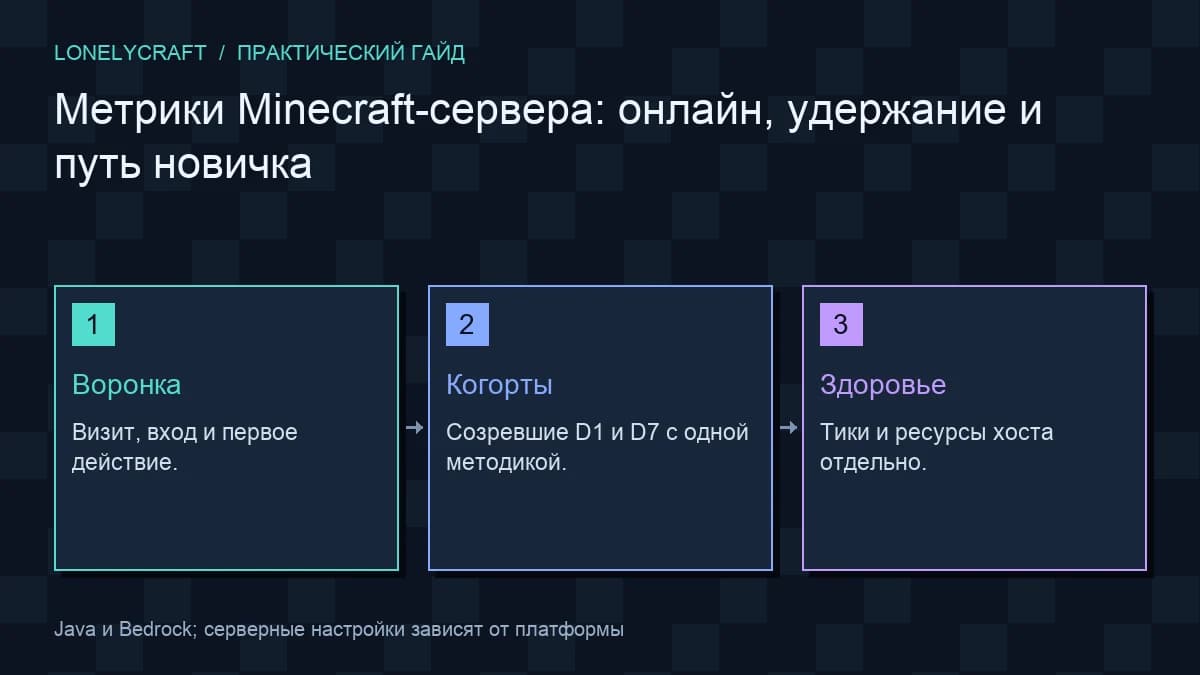
Показатели должны помогать принимать конкретное решение. Для Minecraft-сервера полезны две группы: техническое состояние и путь игрока. Первая объясняет задержки и аварии; вторая показывает, доходят ли новички до обычной игры и возвращаются ли позже. Большой онлайн сам по себе не описывает ни устойчивость сервера, ни удержание.
Сначала сформулируйте несколько вопросов: когда ухудшаются тики, сколько новых людей реально вошло, кто начал играть после регистрации и какая часть вернулась. Для каждого задайте определение события, временной интервал и источник. Если две службы считают «нового игрока» по-разному, красивый общий график будет вводить в заблуждение.
Не собирайте сразу все возможные данные. Начните с небольшого набора, который можно проверить вручную. Затем добавляйте показатели по мере появления вопросов. Больше линий на дашборде не означает больше полезной информации, если неизвестно, как именно они получены.
Технический минимум
Первую проверку можно провести без дашборда: /spark tps показывает состояние тиков, /spark health открывает обзор CPU/памяти/диска, /spark ping сравнивает игроков. В старом spark название health может отличаться; сверяйте /spark help с документацией команды. На Linux дополните free -h, df -h . и systemctl status minecraft.service (замените имя сервиса).
Для постоянного наблюдения node_exporter отдаёт системные метрики, но не знает сам по себе о Minecraft-онлайне, убийствах или донатах. Нужен отдельный игровой exporter/API. UUID, ник и IP не добавляйте метками ко всем Prometheus-сериям: это резко увеличивает число рядов. Игровые события храните отдельно с контролем повторной доставки.
Разделить симптомы помогает статья FPS, TPS и пинг.
Игроки: вход, активность и сессия
Новый игрок — уникальный игровой идентификатор, впервые успешно допущенный к выбранному игровому этапу. Определите, считается ли событие после регистрации и авторизации. Сетевое обращение, попытка подключения и успешный вход нельзя складывать в один показатель: они отвечают на разные вопросы.
DAU считает уникальных активных игроков за выбранный день, а peak online — максимальное одновременное число участников в том же интервале. Один человек с десятью входами должен оставаться одним в DAU, но его сессии могут учитываться отдельно. Укажите, как обрабатываются AFK, краткие переподключения и технические аккаунты.
Длительность сессии требует событий начала и окончания. При аварии последний выход может отсутствовать, поэтому предусмотрите явное правило закрытия незавершённой сессии. Для анализа «играл больше 30 минут» решите, имеется в виду одна сессия или сумма активного времени за день. Эти определения нельзя незаметно менять между отчётами.
| Поле | Пример | Зачем оно нужно |
|---|---|---|
| event_id | уникальный ID события | Защита от повторного счёта |
| session_id | один ID на вход и выход | Связать границы сессии |
| player_id | внутренний игровой ID | Считать уникальных участников |
| occurred_at | UTC-время события | Правильно построить дни и длительность |
| event_type | session_started / session_ended | Отличить начало от конца |
Минимальные поля события сессии
Для начала и завершения храните стабильный внутренний идентификатор игрока, идентификатор сессии, тип события и точное время. Повторно доставленное событие с тем же event_id должно обрабатываться один раз. Для незавершённой сессии отдельно сохраняйте причину закрытия: авария не должна выглядеть обычным добровольным выходом.
Возврат на следующий день и через неделю
D1/D7 считайте по календарным датам в заранее выбранном часовом поясе. Для примера: из100 новых игроков понедельника23 вошли во вторник, D1=23%; если12 вошли в следующий понедельник, D7=12%. Вернувшийся только в воскресенье в D7 этого определения не входит. Когорты младше семи суток не показывайте как0% D7 — результат ещё не готов.
Создайте события с event_id, UUID, event_type, occurred_at: successful_join, session_end, first_action, confirmed_payment. Для first_action отметьте первое участие в мини-игре или первое действие Survival. Уникальный event_id предотвращает удвоение при повторной отправке. Сессию считайте от успешного входа до выхода; аварийный разрыв закройте по документированному таймауту.
Проверяемый пример когорты
В когорте первого входа 100 игроков. Во вторник вернулись 23 из них, значит D1 = 23 / 100 × 100 = 23%. Для D7 проверьте этих же 100 игроков в следующий понедельник. Если там вернулось 12, D7 = 12%. Новые игроки вторника в знаменатель понедельничной когорты не входят.
Первый полезный шаг новичка
Выберите события, которые отражают знакомство с сервером: начало мини-игры, добыча в Survival, создание дома или выполнение подходящего задания. Простое открытие меню и завершение первого раунда — разные уровни вовлечения. Можно иметь оба показателя, но их нужно назвать и считать отдельно.
Такой подход показывает место потери: люди не подключились, не завершили вход или не поняли, куда идти после него. Исправление интерфейса следует проверять на одинаковом определении события. Если одновременно изменить правила счёта, сравнение до и после потеряет смысл.
- Определите когорту новых игроков и момент начала наблюдения.
- Запишите первое подходящее действие один раз для каждого участника.
- Укажите окно конверсии, например первый день или определённое число часов.
- Рассчитайте долю игроков с действием среди подходящей когорты.
- Сравните результат после изменения входа, меню или инструкции.
Спроектировать понятный вход поможет руководство первые шаги нового игрока.
Донаты и ARPPU
Пример за месяц: 200 активных игроков,10 разных плательщиков, подтверждённая выручка15000₽. Donation conversion=10/200×100=5%; ARPPU=15000/10=1500₽. Если плательщиков0, ARPPU не определён: отображайте «нет данных», а не делите на ноль. Покупки за игровое золото не входят в рублёвую выручку.
В тестовой БД повторно передайте одну оплату с тем же event_id: доход и число оплат не должны увеличиться. Отдельно проверьте отмену/возврат и обозначьте, показываете gross или net revenue. Аналогично один посетитель сайта и один UUID игрока не становятся автоматически одной персоной: для такой воронки нужна явно согласованная связка.
Как организовать вывод
Для локального теста на Linux скачайте архив node_exporter для своей архитектуры с официальных releases. Распакуйте tar -xzf ИМЯ_АРХИВА.tar.gz, перейдите в созданную папку и запустите ./node_exporter --web.listen-address=127.0.0.1:9100. Во втором терминале выполните curl -fsS http://127.0.0.1:9100/metrics: должны появиться строки node_. Подробности — в руководстве Prometheus.
Prometheus скачайте с официальной страницы. Создайте prometheus.yml со следующим содержимым и запустите ./prometheus --config.file=./prometheus.yml --web.listen-address=127.0.0.1:9090. В браузере откройте localhost:9090 и страницу Status → Targets: node должен быть UP. Этот пример предполагает оба процесса на одной машине без контейнеров; localhost внутри отдельного контейнера указывает на сам контейнер.
- Установите Grafana по официальной инструкции для своей ОС и откройте её локальную страницу.
- Connections → Add new connection → найдите Prometheus → Add new data source. В Prometheus server URL введите адрес, доступный именно процессу Grafana, например
http://127.0.0.1:9090на той же машине. Нажмите Save & test. - Откройте Dashboards → New → New dashboard → Add visualization, выберите этот источник.
- Для загрузки CPU используйте
100 * (1 - avg by (instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))); для доступной RAM —node_memory_MemAvailable_bytes, для доступного диска —node_filesystem_avail_bytes. - Для D1/D7 и оплаты подключите агрегаты событий через отдельный источник. Node exporter этих данных не создаёт. Не публикуйте административные панели и /metrics без ограничения доступа.
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: node
    static_configs:
      - targets: ["127.0.0.1:9100"]
Проверка и действия
Пройдите контрольный сценарий тестовым аккаунтом: первый вход, начало режима, выход и повторный вход в предусмотренный день. Сверьте события, агрегат и график. Проверьте повторную доставку данных, чтобы один вход или платёж не учитывался дважды.
Каждому сигналу назначьте действие. Падение доступности требует проверки процесса; ухудшение тиков — профиля; падение первой конверсии — проверки входа и меню. Когда определения и действия ясны, даже небольшой дашборд становится полезным инструментом сопровождения сервера.